記事内に広告が含まれています。
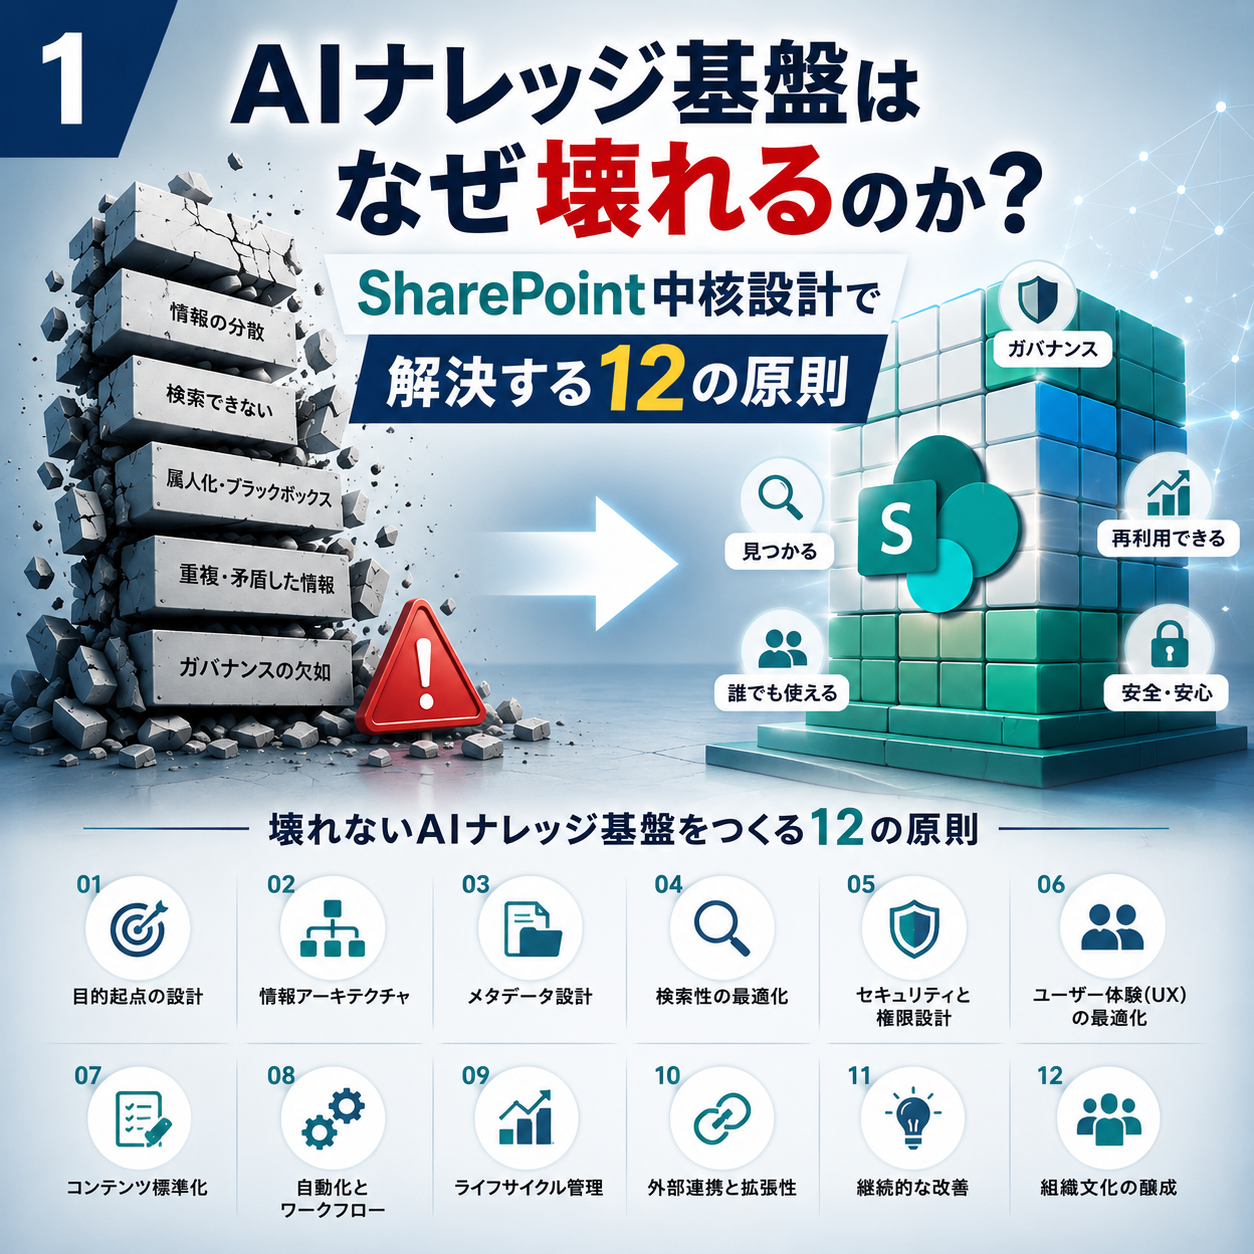
会社の業務でMicrosoft Copilotを使うようになると、大量の資料を検索し、要約し、質問へ回答させること自体は、思ったより簡単に実現できます。
しかし、しばらく運用すると、本当に難しいのは「AIに資料を読ませること」ではないと分かります。
難しいのは、次の問いへ継続的に答えられるKnowledge基盤を作ることです。
- その情報は、どの原本のどのVersionに基づいているか
- 抽出結果はAIが生成しただけか、人間またはValidatorが確認したか
- 過去の誤記やConflictは、どのDecisionによって訂正されたか
- 原本の改訂後に、どのClaimを再検証する必要があるか
- AIのConversationやSessionが終了しても処理を再開できるか
- 複数部門へ展開しても、原本、権限、状態、用語を混同しないか
- AIが閲覧できない情報を「存在しない」と誤判定しないか
- 検索結果や生成されたViewが壊れても、根拠から再構築できるか
この記事では、Microsoft 365とSharePointを業務基盤として利用し、既存の原本、Version、権限、保持、監査を尊重しながら、AIがKnowledgeを抽出、検証、統合するためのArchitecture patternを整理します。
対象業界は限定しません。設計Document、技術資料、品質記録、保全資料、契約Document、標準書、業務手順等、根拠と改訂履歴が重要な仕事へ応用できます。
本記事で説明するAtomic Record、System Links、Negative Knowledge、Runtime Record等はMicrosoft製品の公式機能名ではありません。
SharePoint、OneDrive、Microsoft Purview、Microsoft Copilot等の公式機能を土台に、Knowledgeを長期間運用するために定義したArchitecture上のRecordと運用Contractです。
この記事でわかること
- 単純な「AI検索」だけでは長期運用が難しい理由
- 公式のMicrosoft 365機能と、独自に設計するKnowledge Recordの境界
- 原本を保護しながらKnowledgeを蓄積する6つの責務
- KnowledgeをAtomic Recordへ分解する方法
- Negative Knowledge、Conflict、Correction、Decisionの残し方
- Source Versionの変更とKnowledgeを追従させる方法
- AIのSessionが消えても再開できるRuntime設計
- 複数部門へ水平展開するためのContract
- 導入Roadmapと失敗しやすい設計
- 最初に結論
- Microsoft 365が提供するものと、独自に設計するもの
- 単純なAI検索だけでは長期運用できない理由
- 4層ではなく、6つの責務として設計する
- 最も重要な原則は「原本を動かさない」こと
- Source Pointerは一つのURLではない
- Hashだけで変更や同一性を判断しない
- KnowledgeをAtomic Recordへ分解する
- Conflictを解消前に消さない
- Negative Knowledgeを正しく記録する
- Correctionは旧Claimを削除しない
- Sourceが改訂された後の追従
- 状態Modelは層ごとに分離する
- 識別子を使い回さない
- AIのRuntime stateも永続化する
- 1回の処理量をAtomic Taskへ制限する
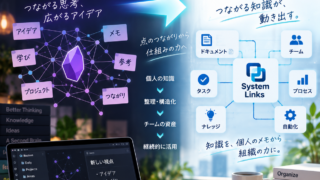
- System Linksで全件列挙への依存を減らす
- File操作とSystem Links更新を一つの完了条件にする
- 人間向けViewは再生成可能にする
- 変化への追従は「自動確定」ではない
- 複数部門へ展開する際の分離
- 個人領域から共有KnowledgeへのContribution
- SecurityとGovernance
- 複数AgentによるReview
- 自律Loopに終了条件を持たせる
- 外部解析、Simulation、CADへの拡張
- 導入Roadmap
- 導入時に行うE2E Test
- 失敗しやすい設計
- 実装前Checklist
- まとめ:15の原則
- シリーズの他の記事
- 公式参考資料
- こんな人におすすめ
- よくある質問
最初に結論
- 原本は既存の部門SiteやDocument Libraryに残す
- AI生成情報を原本と同じ権威で扱わない
- Knowledgeを小さなClaim、Relation、Conflict、Decisionへ分解する
- Source Pointerには論理ID、Storage ID、Version、位置、取得時点を保持する
- Hashは内容一致の判定材料として使い、Entityや原本の同一性をHashだけで決めない
- 原本の変更検知と、Claimの再検証を別Processとして設計する
- Conversation historyを正式なDecisionやRuntime stateの正本にしない
- AIが判断できない場合は、推測せずConflict、Blocked、Inconclusive等として停止する
- 検索結果やHTML Viewは正本ではなく、Atomic Recordから再生成できるProjectionとする
- 最初から全社統合せず、一つの部門でConflict、Correction、Recoveryまで実証する
Microsoft 365が提供するものと、独自に設計するもの
Microsoft 365には、Knowledge基盤に利用できる公式機能があります。
| Microsoft 365側の機能 | 主な役割 |
|---|---|
| SharePoint/OneDrive Access control | 利用者が閲覧、編集できるContentを制御 |
| SharePoint Version history | 過去Versionの表示、比較、復元、変更履歴の確認 |
| Microsoft Purview Retention | PolicyやLabelに基づくContentの保持と削除 |
| Sensitivity labelとEncryption | 機密区分、利用権限、Content protection |
| Microsoft Purview Audit | 対応するMicrosoft 365およびAI interactionの監査 |
| DLP | 機密情報を含むData処理や移動の制御 |
| Microsoft CopilotのGrounding | 利用者がAccess可能なContentをContextとして回答へ利用 |
一方、次の情報は、業務要件に合わせて独自に設計する必要があります。
- どのClaimがどのSource Versionから抽出されたか
- Claimを誰が、何によって検証したか
- 複数SourceのConflictをどのように保持するか
- どのDecisionがどのClaimを採用、却下、訂正したか
- Source改訂時にどのClaimを再検証するか
- AgentのSession、Claim、Lease、Lock、Handoverをどう管理するか
- 部門別の状態を統合層の状態へどう対応づけるか
- HTMLやDashboardをどのAtomic Recordから再生成するか
Microsoft 365の監査と業務意味の監査は別
Microsoft 365のAuditは、対応する操作やInteractionを追跡するための基盤です。
しかし、「なぜこの設計値を採用したか」「どのConflictを誰のDecisionで解決したか」という業務上の意味までは、PlatformのAuditだけで表現できません。
その部分はDecision Record、Source Pointer、Verification Record、Correction Event等として別に保存します。
単純なAI検索だけでは長期運用できない理由
1. AIの回答と原本の境界が曖昧になる
Copilotの回答、要約、抽出結果は、利用者が情報を理解するための支援として有効です。
ただし、AI生成Contentには不完全、誤り、古い情報が含まれる可能性があります。生成結果を人間が確認せず、正式な設計値、契約条件、安全条件として保存すると、推定値が確定情報として再利用される危険があります。
そのため、少なくとも次の3種類を分けます。
| 種類 | 意味 |
|---|---|
| Source Fact | 特定の原本Versionと位置から直接確認できる記載 |
| Derived Claim | 複数Sourceの比較、計算、解釈によって生成した主張 |
| Decision | 人間または承認済みProcessが採用、却下、保留した判断 |
2. Accessできない情報と、存在しない情報を区別できない
Microsoft Copilotは、利用者がAccessを許可されたContentだけを参照します。CopilotがSourceを発見できなかった場合でも、組織内にそのSourceが存在しないとは限りません。
次の状態を分ける必要があります。
- NotFound:定義したSearch scope内で不存在を確認
- AccessDenied:対象候補はあるが権限不足
- SearchIncomplete:Pagination、Timeout、Index等の理由で探索未完了
- NotIndexed:検索結果に現れない可能性がある
- NotApplicable:対象範囲に本来存在しない
- Unknown:判断に必要なEvidenceが不足
3. 大きな一つのFileへKnowledgeを集約すると壊れやすい
一つのMarkdown、JSON、ExcelへすべてのKnowledgeを追加し続ける方式は、初期構築が簡単です。
しかし、Recordが増え、複数Agentや複数利用者が更新すると、次の問題が発生します。
- 同時更新による変更の消失
- 全文置換による一部欠損
- 同じClaimの重複登録
- Current stateと過去履歴の混在
- File sizeとContext sizeの増大
- 一部分だけ取得した内容を全文と誤認
- どの記述が現在有効か判別できない
Knowledge本体はAtomic Recordへ分け、大きなHTML、Markdown、DashboardはProjectionとして再生成します。
4. 「存在しない」「未決定」という知識が消える
通常の検索結果には、見つかった情報だけが残ります。
しかし業務では、次のようなNegative Knowledgeにも価値があります。
- 定義した範囲を調べたが、該当Documentが確認できなかった
- 対象Versionにも期待した設定欄が存在しなかった
- Revisionは進んだが、Hold表記は解除されていなかった
- 決定権限を持つRecordが確認できなかった
- 複数の状態語彙を対応づける正式Mappingが存在しなかった
- 対象SourceへAccessできず、不存在かどうか判断できなかった
Negative Knowledgeには、検索範囲、検索条件、確認日時、確認方法、権限状態、有効期限を付けます。
5. Conversation historyをRuntime stateにできない
AIのConversationは作業Contextとして利用できますが、正式な業務台帳や並行制御の正本には向きません。
別Sessionや別Agentが同じ履歴を参照できるとは限らず、途中状態、未解決事項、書込予定、Lock、承認を再構成できない場合があります。
正式な状態はSharePoint、Dataverse、Repository等の外部永続層へ保存します。
AI導入では、検索機能の高度化より先に、原本、Knowledge、Decision、Runtime、Governance、Projectionの境界を設計する必要があります。
4層ではなく、6つの責務として設計する
元の4層構成は全体像を理解するには有効ですが、長期運用では「保存場所」と「役割」を分けた方が明確です。
ここでは、6つの責務として整理します。物理的に6つのSharePoint Siteを作るという意味ではありません。
| 責務 | 役割 |
|---|---|
| 1. Source of Record | 部門別の原本、Version、権限、保持、正式なMetadataを管理 |
| 2. Extraction and Validation | 原本を読取り、Source Pointer、Claim、Relation、Conflict候補を生成、検証 |
| 3. Canonical Knowledge | 共通Schema、Entity、Relation、Decision、Correction、Negative Knowledgeを統合 |
| 4. Runtime and Recovery | Session、Claim、Lease、Lock、Handover、Retry、Partial Successを管理 |
| 5. Governance and Contribution | Schema、ID、状態語彙、PII、Approval、提交流程、Compatibilityを管理 |
| 6. Projection and Consumption | HTML、Dashboard、Report、検索用View、Agent向けSubgraphを生成 |
責務1:Source of Record
各部門が現在管理しているSharePoint Site、OneDrive、Document Library等を原本境界として扱います。
- AIの都合だけでFolderを再編しない
- AIの都合だけでFileをRenameしない
- 原本と解析用Copyを区別する
- SharePoint Version historyを維持する
- Retention、Sensitivity、Access controlを継承または明示確認する
- 原本の正式なOwnerと承認Processを変更しない
責務2:Extraction and Validation
部門別AgentやWorkflowは、部門固有の用語、文書構造、図面規則を理解し、原本からAtomic Record候補を生成します。
この責務では、AIの出力を直ちにCanonical Knowledgeへ昇格させません。
Source取得
  → VersionとMetadata確認
  → Content抽出
  → Source Pointer生成
  → Claim候補生成
  → Schema validation
  → Evidence照合
  → PendingまたはVerified
  → Contribution Package生成
責務3:Canonical Knowledge
各部門から提出されたPackageを共通Contractで受け入れます。
中央へ原本Fileを集めるのではなく、次を統合します。
- Canonical Entity
- Source Pointer
- Claim
- Relation
- Conflict
- Decision
- Correction
- Negative Knowledge
- Verification Record
- Supersession
責務4:Runtime and Recovery
Agentの実行状態をKnowledge本体と分離して保存します。
大量File、画像PDF、外部Tool、Timeout、権限不足、CreditやCapacity等により、一つのSessionで処理が完了しないことを前提にします。
責務5:Governance and Contribution
部門別Schema、共通Schema、状態語彙、識別子、Approval、PII、Version compatibilityを管理します。
個人OneDrive、部門Site、統合層のState machineを無理に一つへ統一せず、異なるLifecycleはNamespaceで分けます。
責務6:Projection and Consumption
Atomic Recordをそのまま人間へ見せると理解しにくいため、用途別のProjectionを生成します。
- 設備別View
- 系統別View
- Document別View
- Revision history
- 未解決Conflict一覧
- 未検証Claim一覧
- Correction一覧
- Source変更後の再検証待ち一覧
Projectionは閲覧の入口であり、原本またはCanonical Knowledgeの正本ではありません。
最も重要な原則は「原本を動かさない」こと
AI Knowledge基盤を作ると、検索しやすくするために原本を中央Siteへ集めたくなります。
しかし、機械的な複製が増えると、次の問題が生じます。
- どのCopyが正本か分からない
- 各部門のVersion履歴と分離する
- 元のSensitivity labelや権限を正しく再現できない
- 保持PolicyやLegal holdの境界が変わる
- 更新の同期遅延が発生する
- 削除、訂正、SupersessionがすべてのCopyへ反映されない
原本保護の基本
原本は既存のSource of Recordに残し、AIは許可された権限で参照します。
統合層には、論理Source ID、Storage ID、Site、Library、Path、URL、Version、PageやCell等の位置、取得日時、Hash、Verification statusを記録します。
ただし、これらの値を一つの「永続ID」として混同しません。
Source Pointerは一つのURLではない
原本への参照をURLだけで保存すると、Move、Rename、Site変更、Migration等で追跡できなくなる場合があります。
Source Pointerは、複数の識別材料を持つRecordとして扱います。
{
  "sourceId": "SRC-...",
  "canonicalEntityId": "DOC-...",
  "siteId": "...",
  "driveId": "...",
  "itemId": "...",
  "path": "...",
  "webUrl": "...",
  "sourceVersionId": "...",
  "locator": {
    "page": 12,
    "section": "Protection",
    "cell": null,
    "region": null
  },
  "contentHash": {
    "algorithm": "SHA-256",
    "value": "..."
  },
  "retrievedAt": "...",
  "verificationStatus": "Verified",
  "accessStatus": "Accessible"
}| 識別材料 | 用途 | 注意点 |
|---|---|---|
| Canonical Source ID | Knowledge基盤内の論理識別 | 基盤側で一意性と不変性を管理 |
| Site/Drive/Item ID | Storage上のItemを取得 | Copy、Migration、再作成等を考慮 |
| Path | 人間が位置を理解 | MoveやRenameで変化 |
| Web URL | 人間向けNavigation | 論理Entity IDとして使用しない |
| Version ID | 特定時点のSourceを識別 | Current FileへのLinkと分ける |
| Content Hash | 内容変化や重複候補を検出 | 同一Entityや同一原本を証明しない |
| ETag | 書込前後や並行更新を確認 | 更新により変化する |
Hashだけで変更や同一性を判断しない
「File nameではなくHashで変更を判定する」という考え方は有効ですが、Hashだけでは不十分です。
同じHashは、同じByte列であることを示す材料になります。しかし、次の可能性があります。
- 同じTemplateを複数案件に配置した
- 同じAttachmentを異なる原本境界へ保存した
- 正式原本と作業Copyが一時的に同じ内容である
- 別のEntityが偶然同じ内容を持っている
- Metadataや権限が異なる
反対に、内容上の意味が変わっていなくても、Fileの再保存、内部Metadata、Office形式のPackage構造等によりHashが変わる可能性があります。
変更判定は、次を組み合わせます。
- Source ID
- Storage ID
- Version ID
- Content Hash
- File size
- Modified time
- 業務上のRevision
- Source boundary
- 抽出Contentの差分
KnowledgeをAtomic Recordへ分解する
| Record | 役割 |
|---|---|
| Entity | 設備、Document、案件、工程、設定等の論理対象 |
| Inventory | File、Folder、Version、更新状態、解析状態の棚卸し |
| Source Pointer | 原本、Version、Page、Cell、Region、取得時点への参照 |
| Claim | 一つの主語、述語、値、単位、条件を持つ主張 |
| Relation | Entity間の意味的関係 |
| Conflict | 同時に採用できないClaimまたはSourceの競合 |
| Decision | 採用、却下、保留、訂正、Supersessionの判断 |
| Negative Knowledge | 不存在、未収録、未決定、未確認、Access不能等 |
| Correction | 旧Claim、訂正Claim、理由、影響範囲 |
| Verification | 確認方法、Validator、人間Review、結果、確認時点 |
| Runtime Record | Session、Claim、Lease、Lock、Handover、Retry |
| Projection | 人間またはAgent向けに再構成したView |
Claimの例
{
  "claimId": "CLM-...",
  "subjectEntityId": "EQ-...",
  "predicate": "ratedCurrent",
  "value": 800,
  "unit": "A",
  "qualifiers": {
    "condition": "normalOperation"
  },
  "sourcePointerIds": ["SRC-..."],
  "verificationStatus": "Verified",
  "approvalStatus": "Approved",
  "validFrom": "...",
  "validTo": null,
  "supersededBy": null
}
「設備Aは800Aである」という文章だけでなく、主語、Field、値、単位、条件、Source、Verification、有効期間を分けます。
Atomicは「必ず1 File 1 Record」という意味ではない
Atomic Recordは、独立して識別、検証、訂正、Linkできる最小の論理単位です。
物理保存については、SharePoint List、Dataverse、JSON Lines、小分割File、Partitioned ledger等から、件数、同時更新、検索、保持、権限要件に合う形式を選択します。
Conflictを解消前に消さない
複数Sourceが異なる値を示す場合、AIが信頼できそうな一方を選んで上書きしてはいけません。
Claim A
  └─ Source: Drawing Rev.3
  └─ Value: 800 A

Claim B
  └─ Source: Equipment List Rev.5
  └─ Value: 1,000 A

Conflict
  └─ Type: ValueMismatch
  └─ Status: Open
  └─ ResolutionAuthority: Engineering Review
Conflictには、少なくとも次を持たせます。
- 競合するClaim ID
- 各ClaimのSource Pointer
- Conflict type
- 検出方法
- Severity
- 現在状態
- 解決権限
- Decision ID
- 影響を受けるEntityやProjection
Negative Knowledgeを正しく記録する
Negative Knowledgeは、単なる「見つからなかった」というMemoではありません。
{
  "negativeKnowledgeId": "NEG-...",
  "subjectEntityId": "EQ-...",
  "assertionType": "FieldNotPresent",
  "expectedField": "tripSetting",
  "searchScope": {
    "sourceIds": ["SRC-..."],
    "versions": ["Rev.3"],
    "locationsChecked": ["allPages"]
  },
  "accessStatus": "Accessible",
  "searchCompleted": true,
  "observedAt": "...",
  "validUntil": null,
  "verificationStatus": "Verified"
}
Negative Knowledgeの条件
- 探索Scopeが明示されている
- 探索が完了したか記録されている
- Access権限があったか記録されている
- どのVersionを確認したか記録されている
- どの時点の観測か記録されている
- Source改訂後は再検証対象にできる
単に検索結果が0件だっただけでは、VerifiedなNegative Knowledgeにはしません。
Correctionは旧Claimを削除しない
訂正前の値を削除すると、過去のReport、Decision、設計、発注がなぜその値を使ったのか説明できなくなります。
Old Claim
  → verificationStatus: Rejected
  → validTo: 2026-09-10
  → supersededBy: CLM-NEW

Correction Event
  → oldClaimId: CLM-OLD
  → newClaimId: CLM-NEW
  → reason: Source Version再確認
  → impact: Downstream review required
  → decisionId: DEC-...

New Claim
  → verificationStatus: Verified
  → validFrom: 2026-09-10
Correctionでは、次を記録します。
- 旧Claim
- 新Claim
- 訂正理由
- 訂正根拠
- 訂正承認者またはDecision authority
- 有効期間
- 影響を受けるRelation、Report、設計、Task
- 再検証または再発行の要否
Sourceが改訂された後の追従
Source更新を検知しただけでは、Knowledgeが更新されたことにはなりません。
必要なのは、Source変更と既存Claimの依存関係をたどり、再検証することです。
Source Updated Event
  → Pre-stateとPost-stateを取得
  → Version/Hash/Metadataを比較
  → 影響するSource Pointerを抽出
  → 依存するClaimとNegative Knowledgeを検索
  → StaleまたはRevalidationRequiredへ変更
  → 新Versionを抽出
  → 新旧Claimを比較
  → Unchanged/Updated/Conflictを判定
  → Decisionが必要ならReviewへ送る
  → Projectionを再生成
Source変更後の状態例
| 状態 | 意味 |
|---|---|
| Current | 現在のSource Versionに対して検証済み |
| Stale | Source更新後、再検証が完了していない |
| RevalidationRequired | 変更箇所がClaimのEvidenceに関係する |
| Unchanged | 新VersionでもClaimを支える内容が変わっていない |
| Superseded | 新しいClaimまたはDecisionに置換された |
| Conflict | 新旧Sourceまたは他Sourceとの整合が取れない |
状態Modelは層ごとに分離する
複数Agentと複数層を連携すると、同じ言葉が異なる意味で使われます。
たとえば、個人作業領域のReviewと、統合層のValidatingは異なるLifecycleです。
personalWorkflowState: Review
integrationRuntimeState: Validating
claimVerificationStatus: Pending
approvalStatus: Draft
sourceFreshnessStatus: Stale
submissionStatus: NotSubmitted
一つのstatus Fieldへすべてを詰め込まず、Namespaceを分けます。
状態Mappingの原則
- 異なる層のStateを同じものと仮定しない
- Mappingが存在しない場合は推測しない
- 一対一で対応しない状態を無理に変換しない
- Source側Stateと受入側Stateを両方保持する
- Mapping versionを記録する
- 禁止された同義語を追加しない
識別子を使い回さない
| ID | 識別対象 |
|---|---|
| entityId | 設備、Document、案件等の論理Entity |
| sourceId | 論理Source |
| sourceVersionId | Sourceの特定Version |
| sourceContentHash | Source Contentの内容一致候補 |
| claimId | 一つのClaim |
| relationId | 一つのRelation |
| conflictId | 一つのConflict |
| decisionId | 一つのDecision |
| verificationId | 一回のVerification |
| sessionId | 一回のAgentまたは人間の実行Session |
| workPackageId | 一つの実行依頼Package |
| packageId | 一回のContribution提出 |
| eventId | 一つの業務Event |
形式検証を通過したIDが業務上有効とは限りません。Regexだけでなく、正本Registryとの存在、一意性、状態、Scopeを照合します。
AIのRuntime stateも永続化する
| Runtime Record | 役割 |
|---|---|
| Session | 誰が、何を、どのModeで開始したかを宣言 |
| Work Package | Input、Target、前提、停止条件、Result Schemaを固定 |
| Claim/Lease | 対象TaskやRecordを処理中であることを宣言 |
| Lock | 同じTargetへの並行書込を防止 |
| Pre-state | 書込前のVersion、ETag、Size、Hashを記録 |
| Handover | 次のSessionへ未完了事項と再開位置を渡す |
| Result Package | 観測値、操作、Output、Verification、Errorを返す |
| Closed Record | 終了条件を満たしたことを記録 |
| Retry Record | 再試行理由、回数、次回条件を記録 |
| Recovery Record | Partial Successや不整合のReconcile方法を記録 |
Closedがないことと、失敗したことは同じではない
終了Recordが見つからない場合、検索範囲不足、Pagination未完了、Naming差異、同期遅延、権限不足等の可能性があります。
EvidenceがないままAbandonedやFailedへ変更せず、UnknownまたはInconclusiveとして扱います。
1回の処理量をAtomic Taskへ制限する
対象選定
  → Source取得
  → Pre-state確認
  → 抽出
  → 検証
  → 1つのAtomic RecordまたはPackageを保存
  → 保存後の再読込
  → Runtime/Decision/Status更新
  → 次のEventを登録
一つのTurnやSessionで多数のFileを変更すると、どこまで成功したか判別しにくくなります。
特に複数の正本Recordを更新する場合は、次を定義します。
- 更新順序
- 各更新のPre-state
- 途中失敗時のPartial Success
- Rollbackしてよい操作
- RollbackせずDecisionとして保持すべき操作
- Reconcile Task
System Linksで全件列挙への依存を減らす
大規模なDocument Libraryで、起動のたびにすべてのFolderとFileを列挙する設計は、件数、Pagination、Context、API制限の影響を受けます。
RegistryとSystem Linksを入口にして、必要なSubgraphだけを取得します。
_Home
  → Node Registry
  → Current Status
  → Decision Log
  → Open Threads
  → Active Session/Lock
  → 対象Entity
  → Source Pointer
  → Claim/Relation/Conflict
  → Projection
全件棚卸しが必要な場合は、通常Taskから分離します。
- Paginationを最後まで取得
- CursorまたはWatermarkを保存
- 取得範囲を記録
- 途中停止から再開
- 同じItemを重複処理しない
- 棚卸し完了前に「全件確認済み」としない
File操作とSystem Links更新を一つの完了条件にする
File移動やRenameでは、実体操作だけを完了としません。
Move/Rename前の実体確認
  → Session、Claim、Lock確認
  → Source FileのID、Version、Size、Hash確認
  → 許可された操作を実行
  → 移動後Fileを再取得
  → ContentとMetadataを照合
  → Physical Targetを更新
  → System Linksを更新
  → Registryを更新
  → Event/Result Packageを記録
実体操作だけ成功し、System LinksやRegistry更新に失敗した場合はPartial SuccessまたはConflictです。
人間向けViewは再生成可能にする
Atomic Recordは監査とMachine processingに向きますが、人間が日常的に読むには細かすぎます。
そこで、用途別のHTML、Dashboard、ReportをProjectionとして生成します。
Projectionに表示する情報
- 現在採用されているClaim
- Source DocumentとVersion
- Verification status
- 未解決Conflict
- Superseded Claim
- Correction history
- Source更新後の再検証待ち
- Last generated time
- Projection生成に使ったRecordの範囲
Projectionを手修正して正本にしません。表示修正が必要な場合は、元RecordまたはProjection ruleを修正して再生成します。
変化への追従は「自動確定」ではない
新しいFile、Version、Hash差分、Revision、Hold表示等を検知した場合、AIはInventoryやClaim候補を生成できます。
ただし、変更を検知したことと、新しい値を正式に採用したことは別です。
Detected
  → Extracted
  → Structured
  → Validated
  → Review
  → Approved
  → Submitted
  → Accepted
  → Integrated
組織のContractに定義された状態名がある場合は、その表記を使用します。上記は概念例であり、そのまま既存Contractへ追加するものではありません。
複数部門へ展開する際の分離
共通化するもの
- ID規則
- Contribution Package Schema
- Source Pointer Schema
- ConflictとCorrectionの最小Field
- Verification status
- PIIと機密DataのBoundary
- System LinksのRelation type
- RuntimeとResult PackageのContract
- Version compatibility
- AuditとRetentionの基本方針
部門別に分けるもの
- 専門用語
- Document構造
- Entity type
- Classification
- Access権限
- Verification rule
- Decision authority
- 部門固有のState machine
- Source of Record
共通Schemaへすべての部門固有情報を押し込むのではなく、Core ContractとDomain Extensionを分けます。
個人領域から共有KnowledgeへのContribution
個人Email、Chat、Draft、作業Memoを直接Canonical Knowledgeへ統合しません。
Personal Source
  → Content抽出
  → PII/機密情報Check
  → Source boundary確認
  → Claim候補生成
  → 本人Review
  → Contribution Package生成
  → 統合層でSchema/ID/重複/Conflict検証
  → Accepted/Rejected/Conflict
個人領域に残す情報
- 氏名、連絡先等のPII
- 私的内容
- 本人の未整理なMemo
- 一般化できない人的評価
- 未確認の推測
- 共有承認を得ていない情報
統合候補にできる情報
- 設備構成
- 定格、設定値、図面規則
- 改造内容
- 安全条件
- 根拠Document
- 承認済みDecision
- 業務上必要なRelation
SecurityとGovernance
| 制御点 | 設計上の確認 |
|---|---|
| Least privilege | AgentとToolへ必要最小限の権限だけを付与 |
| User context | 利用者権限か、Service identityか、作成者接続かを明示 |
| Sensitivity | Sourceと生成ContentのLabelを確認 |
| DLP | 個人、部門、統合層、外部Service間のData移動を制御 |
| Retention | 原本、Atomic Record、Runtime、Projectionごとに保持要件を定義 |
| Audit | Platform操作と業務Decisionの両方を追跡 |
| Approval | AI生成、本人Review、提出、受入、統合を別状態にする |
| Access failure | AccessDeniedをNotFoundへ変換しない |
| Generated content | 確認前のAI出力を正式Claimとして再利用しない |
複数AgentによるReview
複雑な設計判断では、生成担当と検証担当を分ける方法があります。
| 役割 | Review観点 |
|---|---|
| Extraction reviewer | Sourceから正しく抽出したか |
| Contradiction reviewer | 反対EvidenceやConflictを見落としていないか |
| First-principles reviewer | 前提、単位、境界条件が妥当か |
| Implementation reviewer | Tool、Schema、権限、状態遷移が実行可能か |
| Safety reviewer | 禁止操作、機密Data、不確実な確定を防げるか |
| Integration reviewer | 他部門や既存ContractとのConflictがないか |
複数Agentの一致は、正しさの証明ではありません。各Review結果にもSource Pointer、Test Result、Verification statusを付けます。
自律Loopに終了条件を持たせる
- 必要なVerification条件を満たした
- 同一結果が定義回数継続した
- 最大試行回数に到達した
- 新しいEvidenceが増えなくなった
- AccessDeniedにより継続不能
- 複数候補から一意に決められない
- Conflictとして人間Reviewへ移した
- ContractまたはSchemaが不足している
「解決不能と認識して安全に停止する」ことも、正常な終了結果として設計します。
外部解析、Simulation、CADへの拡張
| 責務 | 担当 |
|---|---|
| 意味理解 | 生成AI |
| 変更要求の構造化 | 生成AI+Schema validator |
| 計算 | Python、Simulation engine、専用API |
| 座標、Layer、Block、Dimension生成 | 決定論的CAD engine |
| 図面差分 | Parser、Geometry comparison、Image comparison |
| 正式発行 | Approval workflowと人間Review |
CADやSimulationを接続する前に、Entity ID、Source Pointer、単位、Revision、Verification、Conflictが安定している必要があります。
導入Roadmap
| Phase | 内容 | 終了条件 |
|---|---|---|
| Phase 0 | 原本、権限、Version、Retention、Decision authorityを確認 | Source of Recordと禁止操作が明文化されている |
| Phase 1 | 一部門でInventory、Source Pointer、Claimを実装 | 少数Sourceから根拠付きClaimを再現できる |
| Phase 2 | Conflict、Negative Knowledge、Correction、Verificationを追加 | 矛盾を上書きせず、Correctionを履歴付きで処理できる |
| Phase 3 | Session、Lock、Handover、Result Packageを追加 | 途中停止後に外部Recordから再開できる |
| Phase 4 | Contribution Packageと統合層の最小受付を構築 | Schema、ID、重複、Conflictを検証できる |
| Phase 5 | Source改訂からClaim再検証までのE2E Test | 変更の影響範囲を追跡しProjectionを再生成できる |
| Phase 6 | 人間向けHTML、Dashboard、未解決一覧を構築 | ProjectionをAtomic Recordから再生成できる |
| Phase 7 | External analysis、Simulation、CADを接続 | 決定論的ValidatorとApprovalが機能する |
| Phase 8 | 他部門へDomain Extension方式で展開 | Core Contractを壊さず部門固有Ruleを追加できる |
導入時に行うE2E Test
- 原本の特定VersionからClaimを抽出できる
- Page、Cell、Region等のSource位置へ戻れる
- 同名別内容を別Sourceとして扱える
- 別名同内容を重複候補として扱える
- 同一Hashでも別Entityを自動統合しない
- AccessDeniedをNotFoundにしない
- Source改訂後に依存ClaimをStaleへできる
- Conflictを保持したままReviewへ送れる
- Correction後も旧Claimを追跡できる
- 途中失敗をPartial Successとして記録できる
- Session終了後にHandoverから再開できる
- Projectionを原Recordから再生成できる
- 未承認情報を統合層へ提出しない
- 原本を変更せず一連の処理を完了できる
失敗しやすい設計
| 失敗Pattern | 問題 | 修正方針 |
|---|---|---|
| 最初から全社統合する | 部門固有Ruleが多く、Core Schemaが定まらない | 一部門でConflictとCorrectionまで一巡させる |
| 原本を中央へ複製する | 権限、Version、Retention、正本境界が複雑化 | 中央には参照とKnowledge Recordを置く |
| AI出力を直接確定値にする | 推測や誤抽出が正式情報として再利用される | VerificationとApprovalを分ける |
| 承認と提出を同一視する | 本人が承認しても統合層が受理したとは限らない | Approved、Submitted、Accepted、Integratedを分離 |
| 検索結果0件を不存在とする | 権限、Index、Pagination不足を見落とす | Search scopeとAccess statusを記録 |
| File nameだけで同一性を判断する | 同名別内容、別名同内容を扱えない | ID、Version、Hash、Source boundaryを組み合わせる |
| Hashだけで同一Entityと判断する | 同一内容の別原本を誤統合 | Entity、Context、Metadataを照合 |
| Folderへ業務意味を埋め込みすぎる | 組織変更やEntity追加で構造が崩れる | 意味はRegistryとRelationへ置く |
| Conversationを正本にする | 別Sessionや別Agentで再開できない | DecisionとRuntimeを外部永続化 |
| 大きな一つのFileを更新し続ける | 同時更新、欠損、Context超過が起きる | Atomic RecordとAppend-only Eventへ分ける |
| Viewを直接修正する | 元Recordと表示が不整合になる | Projection ruleまたはAtomic Recordを修正 |
| 自動Retryを無制限にする | 重複処理、費用増加、競合拡大が起きる | 有限Retry、Backoff、Idempotency、停止条件を定義 |
実装前Checklist
Source
- Source of Recordが一意に定義されているか
- Version historyの設定と保持条件を確認したか
- Copyと原本を区別できるか
- AccessDeniedを検出できるか
Knowledge
- Entity、Claim、Relation、Conflictを分離したか
- ClaimからSource Versionへ戻れるか
- VerificationとApprovalを分けたか
- Correctionで旧Claimを削除しないか
- Negative KnowledgeにSearch scopeを持たせたか
Runtime
- SessionとWork Packageを識別できるか
- 書込前にLockとPre-stateを確認するか
- Partial Successを表現できるか
- Sessionが消えても再開できるか
- Retry上限と停止条件があるか
Governance
- State machineを層ごとに分離したか
- IDを複数の意味で使い回していないか
- Schema versionとCompatibility ruleがあるか
- PII、機密情報、部門境界を分離したか
- 提出、受入、統合を別状態にしたか
Change and Recovery
- Source改訂から影響Claimを特定できるか
- Hash以外の識別材料も保持しているか
- MoveやRename後にSystem Linksを更新するか
- Projectionを再生成できるか
- 破損時に原本へ影響せず再構築できるか
まとめ:15の原則
- 原本は既存のSource of Recordに残す
- AI生成情報と原本を分離する
- Microsoft 365のVersion、Retention、Auditと独自の業務Recordを混同しない
- KnowledgeをAtomic Recordとして保存する
- Claimから原本のVersionと位置へ戻れるようにする
- URL、Path、Item ID、Version、Hashの役割を分ける
- HashだけでEntityや原本の同一性を決めない
- Conflictを自動的に一方へ統合しない
- 旧ClaimとCorrection理由を削除しない
- Negative KnowledgeにはSearch scopeとAccess statusを持たせる
- Conversationではなく外部Recordを業務状態の正本にする
- 一回の処理量をAtomic Taskへ制限する
- Source改訂後は依存Claimを再検証する
- ProjectionをAtomic Recordから再生成可能にする
- 一部門でRecoveryまで実証してから水平展開する
この設計の目的は、AIを無制限に自律化することではありません。
原本を守り、利用者の権限を尊重し、確認済み情報と未確認情報を区別し、Conflictを隠さず、訂正理由を残し、Sessionをまたいでも業務を安全に再開できる状態を作ることです。
そこまで整備されて初めて、AIは一時的な検索Assistantから、Knowledgeの変化、根拠、判断、訂正を継続的に扱う業務基盤の一部になります。
シリーズの他の記事
- GitHub Copilot harness vs Copilot Studio Classic 実務での選び方を徹底比較
- 「Obsidian第二の脳」からSystem Linksへ SharePoint版Knowledge基盤の作り方
- 「AIにPDF図面を読ませる」を失敗させない設計 段階的解析Pipelineの作り方
- Copilot Studio・Cowork・Scout・Work IQ、結局どれを使えばよいのか
公式参考資料
- Microsoft Learn:SharePointとOneDriveのVersion history
- Microsoft Learn:Document LibraryのVersion history limits
- Microsoft Learn:SharePointとOneDriveのRetention
- Microsoft Learn:Microsoft CopilotのData protectionとAudit architecture
- Microsoft Learn:Microsoft PurviewによるAI InteractionのSecurityとCompliance
- Microsoft Support:Copilot in SharePointのFAQ
こんな人におすすめ
- 会社でCopilotやAI Agentの導入を検討している
- AIの回答は便利だが、SourceとVersionを追跡できず不安を感じている
- 複数人または複数AgentでKnowledgeを更新している
- 原本を中央へ複製せずAI活用したい
- Conflict、Correction、未確認状態を履歴付きで残したい
- AgentのSessionが変わっても業務を再開したい
- 一部門で構築した仕組みを他部門へ水平展開したい
よくある質問
Q. 個人や小規模Teamでも、このArchitectureが必要ですか?
A. すべてのRecordを実装する必要はありません。
小規模でも、原本とAI生成Contentを分ける、SourceとVersionを記録する、Verification statusを付ける、旧値を削除せずCorrectionで置換する、という4点は早い段階で導入する価値があります。
Q. SharePoint以外でも応用できますか?
A. Architecture上の考え方は他のRepositoryにも応用できます。
ただし、Access control、Version、Retention、Audit、Search、IDの挙動は製品ごとに異なります。SharePointから他製品へ移す場合は、Microsoft 365の機能と独自Recordのどちらが担当していたかを分けて移行します。
Q. SharePoint Version historyがあればCorrection Recordは不要ですか?
A. 役割が異なります。
Version historyはFileやItemの過去Versionを確認、比較、復元する機能です。Correction Recordは、どのClaimが誤りで、なぜ訂正され、どの新Claimへ置き換えられ、どの業務へ影響したかを表します。
Q. Content Hashが同じなら同じDocumentと考えてよいですか?
A. 同じByte列であることを確認する材料にはなりますが、同じ論理Document、同じEntity、同じ原本であることまでは証明しません。
Source boundary、Version、Metadata、業務Context、Canonical Entityも照合します。
Q. Copilotが見つけられなかった場合、「資料なし」と記録できますか?
A. 検索結果が0件というだけでは不十分です。
Search scope、Pagination完了、Access権限、Index状態、対象Versionを確認できた場合に限り、範囲を限定したNegative Knowledgeとして記録します。
Q. AI AgentのMemoryをDecision Logとして利用できますか?
A. AgentのMemoryは将来のInteractionへContextを提供する用途には利用できますが、正式なDecision、Approval、Lock、Auditの正本としては分離した方が安全です。
Q. 導入にどれくらいの期間が必要ですか?
A. 一律の期間は示せません。対象File数だけでなく、原本の所在、権限、Version、Schema、Conflict、承認Process、Connector、既存Data品質によって必要作業が変わります。
期間を先に固定するより、各Phaseに終了条件を設定し、一部門の少数SourceでE2Eを確認してから対象範囲を広げます。
本記事のMicrosoft製品情報は2026年9月10日時点です。Microsoft Copilot、Copilot in SharePoint、Microsoft Purview、Version管理、Retention、Audit、Preview機能の提供条件は変更される可能性があります。導入時には対象TenantのLicense、Admin設定、Microsoft Learn、組織Policyを確認してください。
コメント